

Про бэкапы есть старая шутка. Люди делятся на тех, кто делает резервные копии, и на тех, кто уже начал. Есть и третья категория - те, кто пока не делает, но обязательно начнёт после первой серьёзной аварии.
Учиться на своей аварии дорого. Чужой регламент читать скучно, а мысль «базы за последние три года больше нет» приходит без предупреждения. Переживёт проект аварию или нет, решают три вещи: как снимается копия, где она лежит и проверяли ли восстановление.
1. Как теряют данные
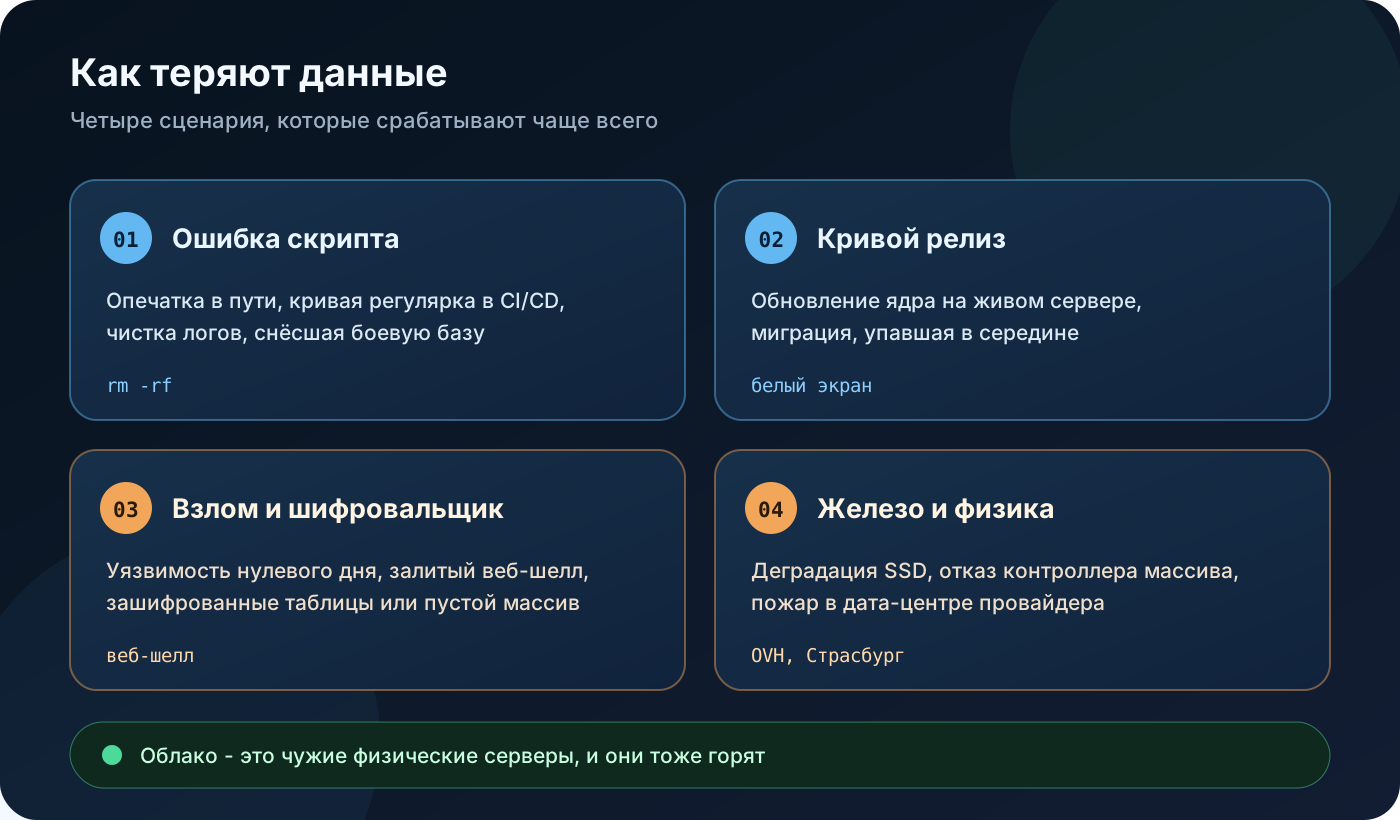
Инфраструктура кажется стабильной, пока не срабатывает один из привычных сценариев.
- Случайный
rm -rfили ошибка скрипта. Опечатка в пути или чистка логов, снёсшая боевую базу за долю секунды. - Кривой релиз или обновление CMS. Апдейт ядра на живом сервере, миграция, упавшая в середине транзакции. Итог - белый экран вместо сайта.
- Взлом и шифровальщики. Уязвимость нулевого дня, залитый веб-шелл, зашифрованные таблицы или вычищенный дисковый массив.
- Железо и физика. Деградация SSD или отказ контроллера дискового массива. Отдельный сценарий - пожар у провайдера. Страсбургский дата-центр OVH напомнил индустрии, что облако - это чужие физические серверы, которые тоже горят.
Дальше начинается бизнес: сорванные сроки и недели ручной пересборки данных.
2. Восемь способов делать бэкапы
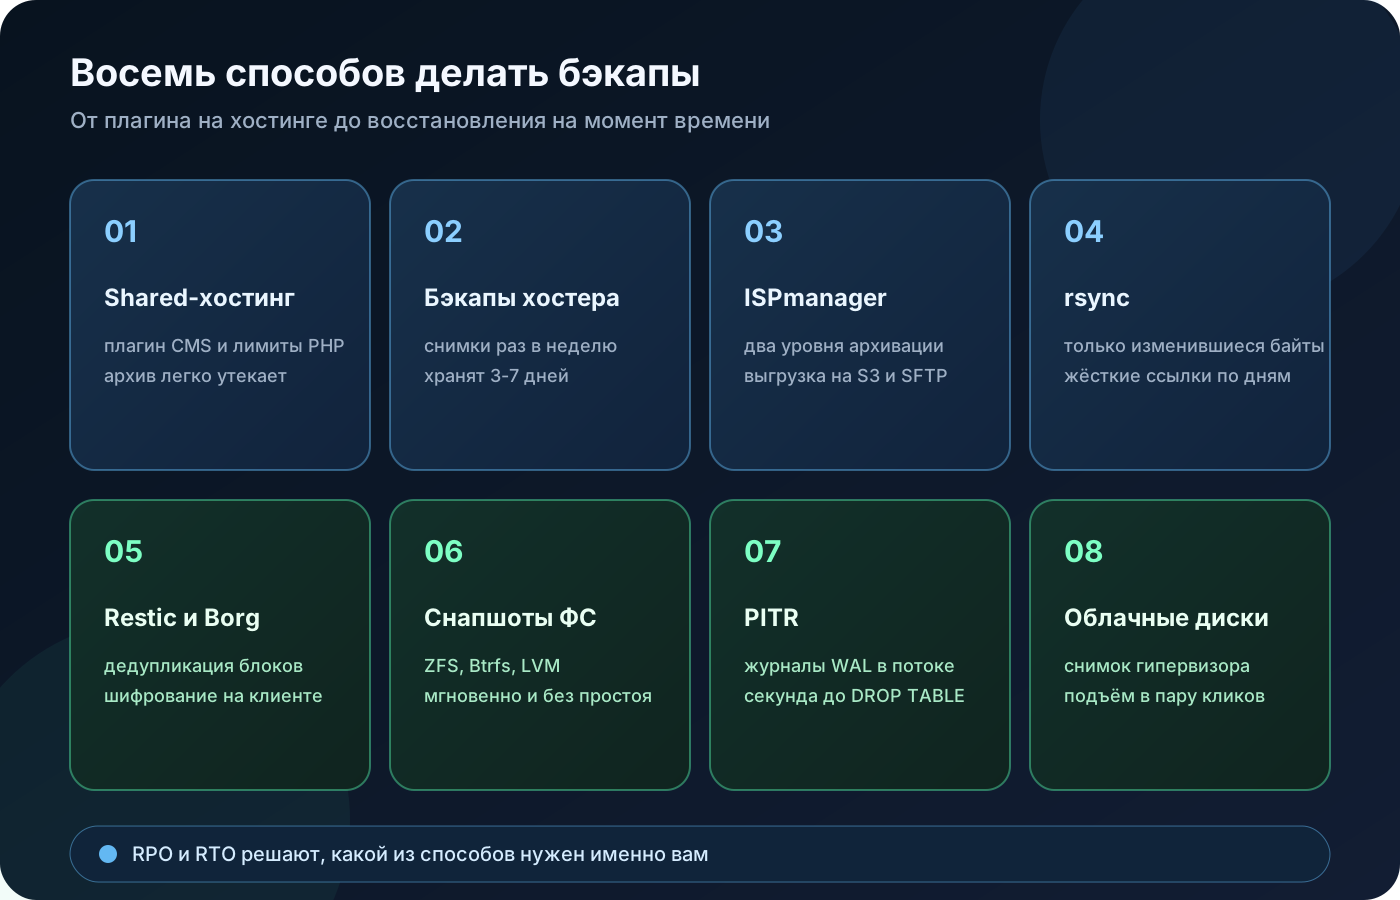
Выбор зависит от доступа к серверу и от того, сколько простоя вы готовы вытерпеть. Две метрики, которыми это измеряют, стоит запомнить сразу: RPO показывает, сколько данных по времени вы готовы потерять, а RTO - сколько времени сервис имеет право лежать.
Shared-хостинг
На виртуальном хостинге вы делите машину с сотнями соседей, и лимиты тут жёсткие. Обычно ставят плагин CMS вроде Akeeba Backup или All-in-One WP Migration.
Засада в том, что архив собирает PHP-скрипт через веб-сервер. На базе в пару сотен мегабайт он упирается в max_execution_time или memory_limit и падает на середине. Второй частый промах - положить готовый zip в public_html. Сканирующие боты перебирают стандартные имена вроде backup.zip и dump.sql и забирают архив вместе с персональными данными и исходниками.
Бэкапы хостинг-провайдера
Провайдер обещает ежедневные копии, но защищает он свою инфраструктуру, а не ваш бизнес. Снимки часто делают раз в неделю, хранят 3-7 дней, а иногда перезаписывают уже повреждёнными данными. Если аккаунт заблокируют за нарушение правил или спор по оплате, доступ к панели уйдёт вместе с копиями. Такой бэкап годится как аварийная подушка, но не как единственная опора.
Панель ISPmanager
На VPS или выделенном сервере панель даёт двухуровневый контур архивации. Администраторский уровень снимает полный слепок системы: конфигурации Nginx, Apache, PHP, почтовые демоны, системных пользователей. Пользовательский настраивается под каждый аккаунт отдельно и умеет разделять архивы: базы MySQL и PostgreSQL, файлы сайтов и почтовые ящики, без тяжёлых временных каталогов вроде node_modules, кэша CMS и логов. Готовые архивы можно сразу отправлять на внешние SFTP или S3 и держать нужную глубину хранения по дням.
rsync
Для серверов с SSH-доступом rsync остаётся классикой. Он считает различия между файлами и передаёт только изменившиеся байты, без монолитного tar.gz. В cron обычно попадают две команды: дамп базы с --single-transaction и --quick, сжатый gzip в локальный каталог, и следом синхронизация файлов и дампов на удалённое хранилище.
rsync -avz --delete \
  -e 'ssh -p 22 -i /root/.ssh/backup_key' \
  /var/www/site/ user@backup-storage.net:/remote/backups/files/
С ключом --link-dest ежедневные снимки делят неизменённые файлы жёсткими ссылками, поэтому месяцы истории занимают немного места.
Restic и BorgBackup
Restic и BorgBackup пришли на смену связке tar и rsync. Они режут данные на блоки переменной длины и отправляют на хранилище только уникальные куски, поэтому дедупликация экономит место. Шифрование идёт на стороне клиента мастер-ключом, целостность архива проверяется встроенными средствами, а складывать копии можно прямо в S3, SFTP или Backblaze B2 без промежуточного файла на диске.
Снапшоты файловых систем
ZFS, Btrfs и LVM снимают состояние мгновенно на уровне ядра по механизму copy-on-write, то есть копированию при изменении. Фиксация терабайтного накопителя занимает доли секунды и не нагружает приложения. Снимок монтируется только для чтения, после чего уезжает по сети родными командами zfs send и zfs receive. Простоя нет.
Восстановление на момент времени
Ночной бэкап означает, что при сбое в 18:00 вы теряете весь рабочий день. Восстановление на момент времени, или PITR, закрывает эту дыру для PostgreSQL и MySQL. Раз в неделю снимается базовый слепок, а журналы опережающей записи - WAL в PostgreSQL или binary logs в MySQL - непрерывно стримятся в отдельное хранилище через pgBackRest или wal-g. Восстановиться можно на конкретную секунду, например ровно перед ошибочным DROP TABLE.
Снапшоты облачных дисков
AWS EBS, Hetzner Cloud, Selectel и Timeweb Cloud замораживают и копируют состояние виртуального диска на уровне гипервизора. Гостевая система не тратит на это ни процессор, ни память, а после шифровальщика или фатального повреждения сервер поднимается из снимка в пару кликов.
3. Правило 3-2-1
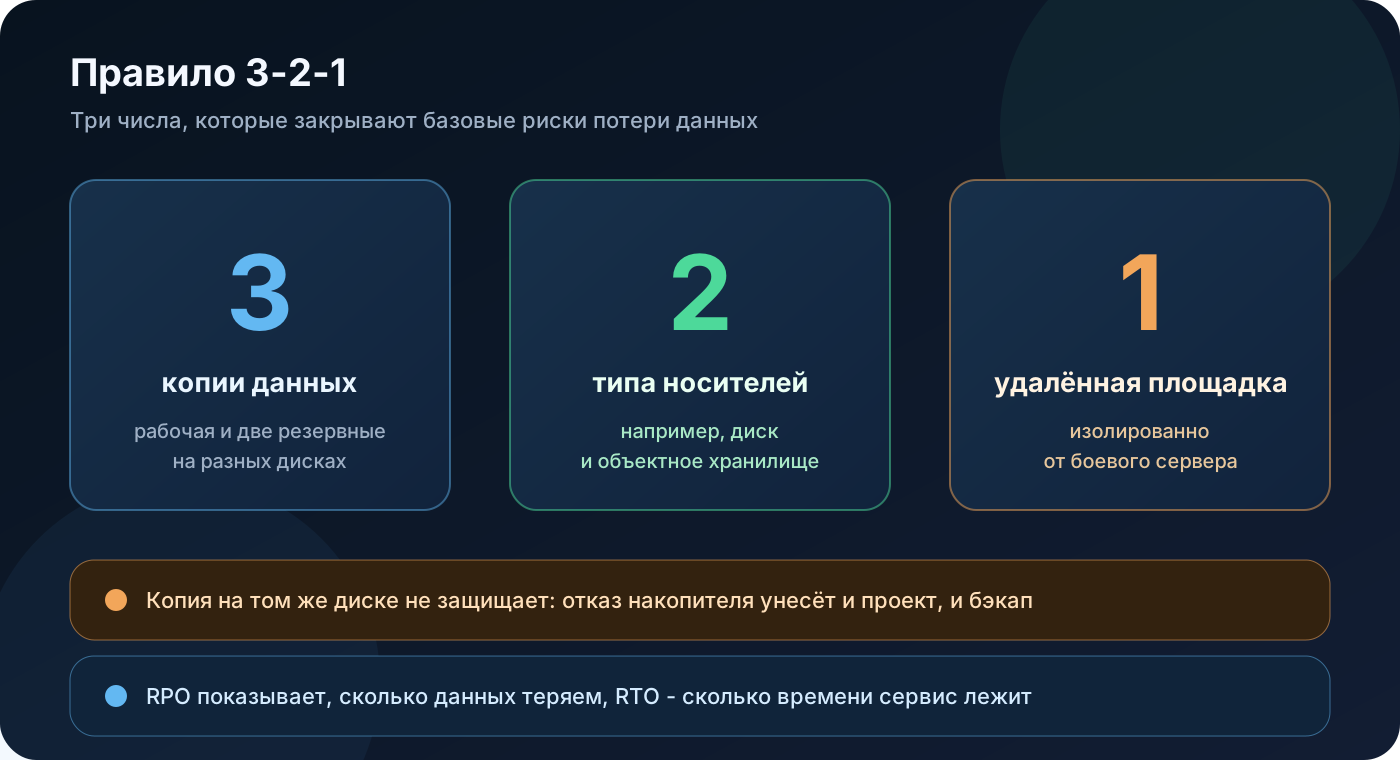
Копия на том же диске, где работает проект, не защищает ни от чего: отказ накопителя или утечка root-доступа унесёт и проект, и бэкап. Рабочий стандарт держится на трёх числах: три копии данных (рабочая и две резервные), два разных физических типа носителей и одна копия на изолированной удалённой площадке.
4. Где хранить копии
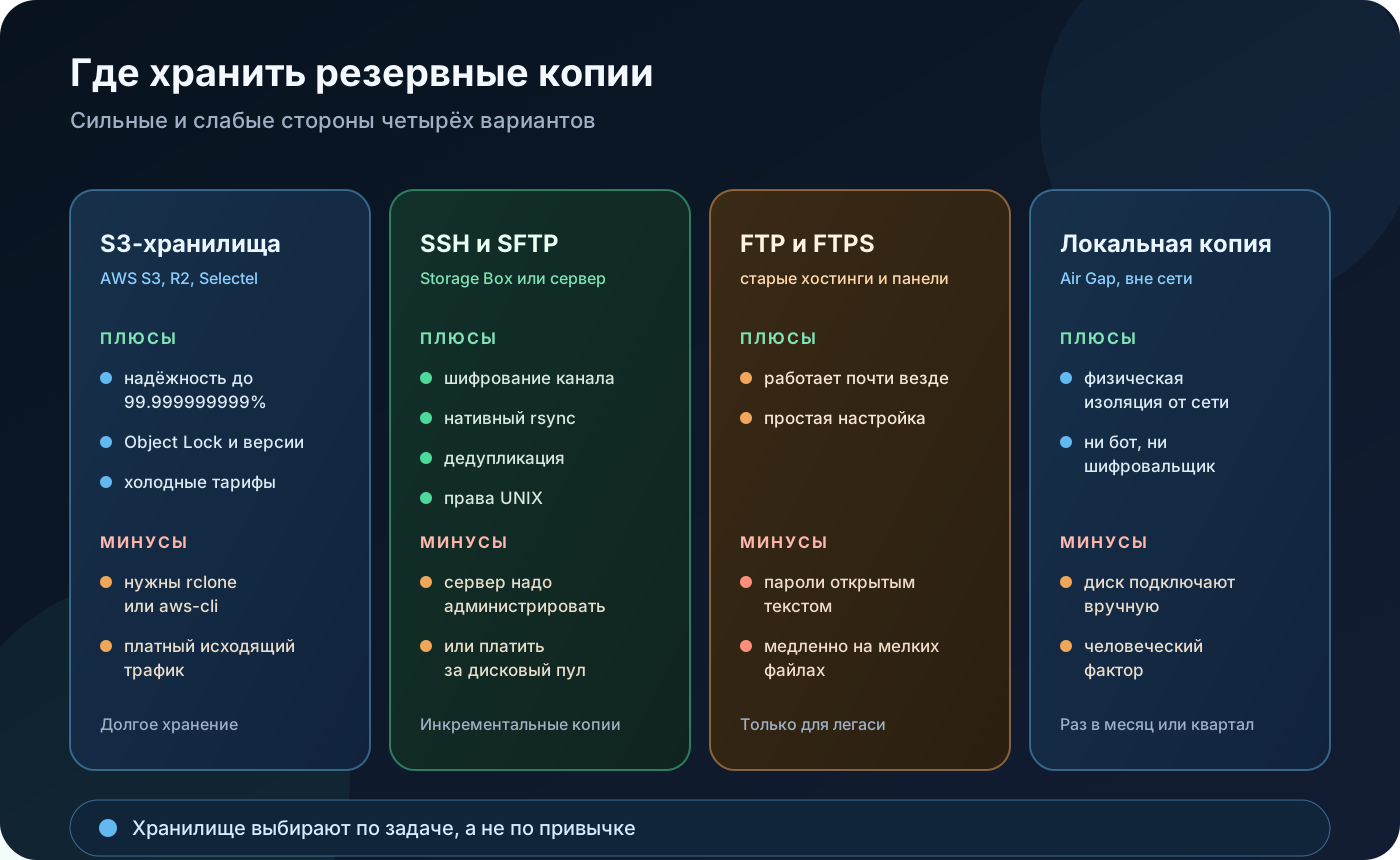
Правило 3-2-1 требует удалённой площадки, а чем именно она будет - вопрос цены, удобства и уровня изоляции.
| Протокол или хранилище | Сильные стороны | Слабые стороны и риски | Когда подходит |
|---|---|---|---|
| S3-совместимые объектные хранилища (AWS S3, Cloudflare R2, Selectel, Yandex Cloud) | Надёжность до 99.999999999%, версионирование, дешёвые холодные тарифы вроде Glacier, Object Lock против удаления шифровальщиком | Нужны клиенты вроде rclone или aws-cli, а часть провайдеров берёт деньги за исходящий трафик | Основное долгосрочное хранилище для проектов любого масштаба |
| SSH и SFTP (Storage Box, выделенный сервер) | Шифрование канала, нативный rsync, дедупликация и права UNIX | Удалённый сервер нужно администрировать или оплачивать дисковый пул | Инкрементальные копии вместе с Restic, BorgBackup и rsync |
| FTP и FTPS | Простота, поддержка любыми старыми хостингами и панелями управления | Обычный FTP передаёт данные и пароли открытым текстом, а много мелких файлов копируются медленно | Старые проекты без SSH-доступа, базовые сценарии хостинга |
| Локальная оффлайн-копия (Air Gap) | Физическая изоляция: до отключённого диска не доберётся ни бот, ни шифровальщик | Человеческий фактор: накопитель нужно подключать, синхронизировать и убирать в сейф вручную | Контрольные архивы раз в месяц или квартал |
5. Почему галочка в панели не спасает
Настроить простой bash-скрипт кажется делом пяти минут, пока не случится боевая авария. Создание копии - это примерно 10% задачи. Остальные 90% - вернуть целые данные под нагрузкой и уложиться в предсказуемое время.
Самостоятельная настройка чаще всего проваливается в четырёх местах.
- Дамп «на лету» оказывается неконсистентным. Если в момент выгрузки по базе идут транзакции, без правильной изоляции вроде
--single-transactionи блокировокflush tablesархив превращается в битый набор данных и потом падает на внешних ключах. - Архиватор запускают в пик нагрузки. Тяжёлый процесс выедает дисковый ввод-вывод и блокирует таблицы, то есть устраивает сайту отказ в обслуживании своими руками.
- Пароли и ключи лежат в открытом скрипте. Root-пароль или ключ S3 с правами
FullAccessпозволяет злоумышленнику, попавшему в веб-приложение, снести и удалённые копии. - Сбой остаётся незамеченным. Скрипт завершается с нулевым кодом, а на выходе пустой архив в ноль байт: кончилась дисковая квота или оборвалась сеть.
Системный администратор или DevOps-инженер строит стратегию аварийного восстановления.
- Сначала считают RPO и RTO, то есть допустимую потерю данных и предельное время восстановления сервиса.
- Бэкап-пользователю выдают минимум прав: чтение и запись без перезаписи и удаления существующих снимков.
- Мониторинг и алерты в Prometheus, Zabbix или Telegram, чтобы о сбое узнавать сразу.
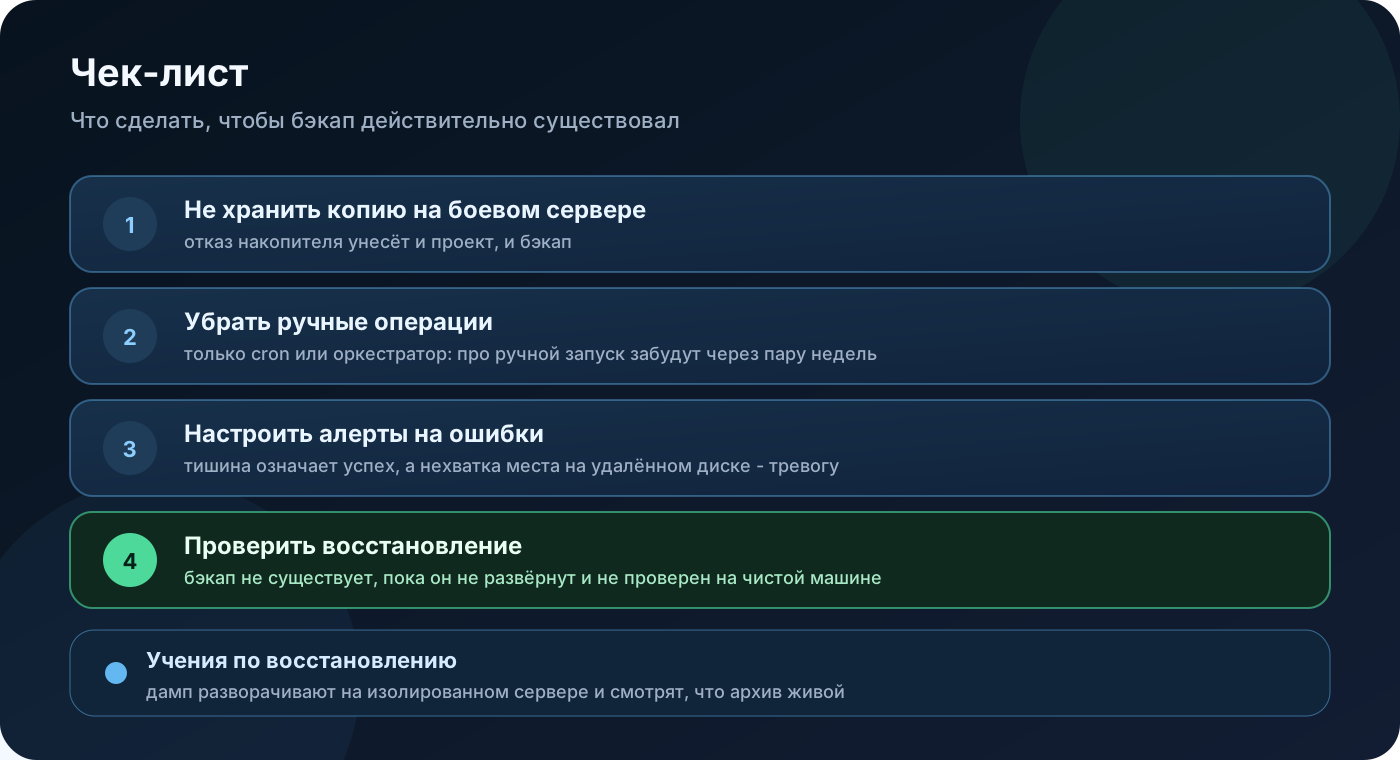
- На учениях дамп разворачивают на изолированном сервере и убеждаются, что архив рабочий.
6. Чек-лист
- Не хранить бэкап на том же сервере, где крутится проект.
- Убрать ручные операции: всё по cron или через оркестратор, иначе через пару недель про это забудут.
- Настроить алерты на ошибки. Тишина в уведомлениях означает успех, а нехватка места на удалённом диске должна сразу поднимать тревогу.
- Считать бэкап несуществующим, пока он не развёрнут и не проверен на чистой тестовой машине.
Если не хочется проверять всё это на своей аварии, напишите нам. Настроим резервное копирование, проверим восстановление и покажем, где в текущей схеме остались дыры.

Обсуждение
Поделитесь мнением — первый комментарий задаст тон.